Les agents IA utilisent-ils WebMCP ? (benchmark octobre 2026)
Résumé IA
Quentin Yacoub a testé si les agents IA personnels utilisent vraiment WebMCP. Meta Muse, Grok Bot, OpenAI Dots et Gemini ont répondu à trois questions sur son site, puis tenté de réserver une voiture et de remplir un formulaire sur un site de test AEM. Il compare réponses, vitesse et traces dans ses logs, avec les leçons SEO et GEO.
Table des matières
This article is also available in English: Do Personal AI Agents Use WebMCP? (October 2026 Benchmark)
WebMCP est adopté très vite, par les navigateurs comme par de gros acteurs. Chrome et Microsoft Edge le testent tous les deux via des « origin trials ». Depuis août 2026, chaque boutique Shopify construite sur Liquid expose des outils WebMCP pour chercher dans le catalogue et gérer le panier, et Shopify les a étendus au paiement en septembre. Cloudflare teste aussi, dans une version pour développeurs, une option qui ajoute WebMCP à n’importe quel site sans toucher à son code.
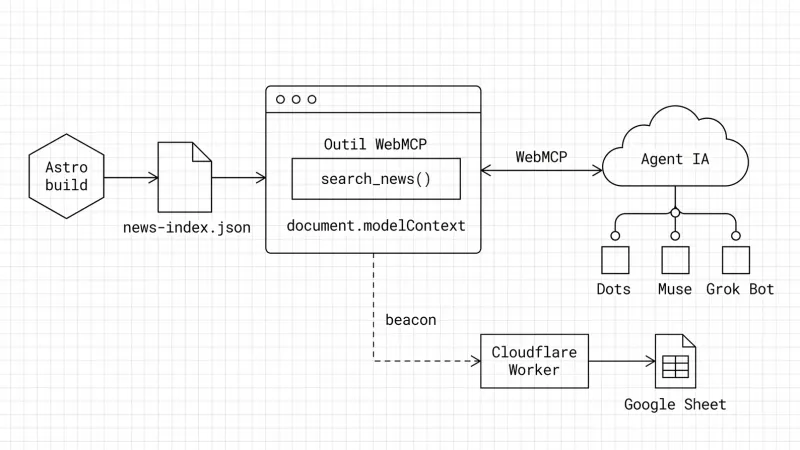
J’ai donc décidé de le tester sur mon propre site. J’ai créé search_news, un outil WebMCP qui permet à un agent IA de chercher directement dans mes actualités SEO, GEO & IA au lieu de cliquer de page en page. J’explique comment dans Comment créer un outil WebMCP.
Mais créer un outil, c’est une chose. Les agents IA personnels utilisent-ils vraiment WebMCP ? Pour le savoir, j’ai mené un benchmark : quatre agents, trois questions sur mon site, de la plus ouverte à la plus précise, chaque essai enregistré, et une vérification de ce qui est arrivé dans mes logs et mes analytics. J’ai ensuite donné aux mêmes agents deux tâches plus concrètes sur un site de test AEM qui expose lui aussi des outils WebMCP : réserver une voiture de location et envoyer un formulaire.
Note : cet article devient technique par moments. Si tu veux juste l’essentiel, clique ici pour que ChatGPT te le résume sans jargon.
Comment j’ai mené le benchmark des agents IA personnels
Les agents personnels testés
Le 13 octobre 2026, j’ai testé quatre agents IA personnels grand public :
- Meta Muse : compte gratuit, application web.
- Grok Bot : compte payant, dans l’application de bureau.
- OpenAI Dots : compte ChatGPT Pro.
- Gemini : compte Google AI Ultra, avec Gemini Spark (le mode Tâche de l’application Gemini).
Chaque question démarrait dans une nouvelle conversation, et j’effaçais la mémoire de l’agent entre deux questions quand il en avait une. Quand un agent s’arrêtait pour me poser une question, je lui donnais une seule réponse courte.
Les trois questions
Chaque agent a reçu les trois mêmes questions (posées en anglais, traduites ici) :
- Q1, une question ouverte : « Sur quentinyacoub.com, trouve toutes les news sur Gemini dans les actualités SEO, GEO & IA, dans toutes les éditions, et donne-moi pour chacune l’avis de Quentin. » Dans mon index des news, 11 news mentionnent Gemini, dont 3 dans leur titre.
- Q2, une question avec filtres : « Quelles news GEO publiées sur quentinyacoub.com depuis le 1er mai 2026 mentionnent ChatGPT ? Liste-les avec leur date de publication. » 5 news correspondent.
- Q3, la même question avec l’outil : la Q2, plus « Utilise l’outil WebMCP search_news du site. »
La Q2 est exactement le type de recherche pour lequel search_news a été conçu : ses filtres gèrent le mot-clé, la catégorie et la date. La Q3 demande l’outil par son nom.
Comment j’ai suivi chaque réponse
Pour chaque réponse, j’ai vérifié trois endroits :
- Mes logs de bots : un Cloudflare Worker enregistre, dans un Google Sheet, chaque requête des bots, des agents qui signent leurs requêtes avec Web Bot Auth, des navigateurs automatisés comme
HeadlessChrome, et chaque requête vers les fichiers lus surtout par des agents (news-index.json,llms.txtet les versions markdown de mes pages), quel que soit le user agent. - Le beacon WebMCP : chaque appel à l’outil enregistre une ligne
/__webmcp, avec l’outil, la requête et si le navigateur se déclare automatisé. - Matomo : mon outil d’analytics, qui ne voit que les visiteurs qui exécutent le JavaScript.
J’explique l’installation du tracking dans comment tracker les agents qui utilisent WebMCP.
Q1 : toutes les news sur Gemini et l’avis de Quentin
| Agent | Trouvé | Avis de Quentin | Durée | A utilisé WebMCP | Logs de bots | Analytics |
|---|---|---|---|---|---|---|
| Muse | ⚠️ 3 sur 11 | ✅ Exacts | ~3 min | ❌ Non | ✅ Oui, navigateur avec un user agent ordinaire | ✅ Une visite |
| Grok Bot | ✅ 11 sur 11 | ✅ En entier | ~40 s | ❌ Non | ✅ Oui, curl | ❌ Aucune visite |
| Dots | ✅ 11 sur 11 | ⚠️ Paraphrasés | ~2 min | ❌ Non | ✅ Oui, curl, signé | ❌ Aucune visite |
| Gemini | ✅ 11 sur 11 | ✅ Mot pour mot | ~2,5 min | ❌ Non | ❌ Aucune requête | ❌ Aucune visite |
Aucun n’a utilisé l’outil pour une question ouverte. Grok Bot et Dots ont trouvé les 11 news en téléchargeant mon index JSON des news, et Muse n’a gardé volontairement que les 3 news avec Gemini dans le titre. Gemini a trouvé les 11 sans qu’aucune requête n’arrive sur mon site.
Q2 : filtrer par catégorie, date et mot-clé
| Agent | Trouvé | Dates de publication | Durée | A utilisé WebMCP | Logs de bots | Analytics |
|---|---|---|---|---|---|---|
| Muse | ⚠️ 4 sur 5 | ❌ Dates d’édition | ~1 min | ❌ Non | ✅ Oui, curl | ❌ Aucune visite |
| Grok Bot | ✅ 5 sur 5 | ✅ Exactes | ~30 s | ❌ Non | ✅ Oui, curl | ❌ Aucune visite |
| Dots | ✅ 5 sur 5 | ✅ Dates d’édition et d’origine | ~1 min | ❌ Non | ✅ Oui, ChatGPT-User | ❌ Aucune visite |
| Gemini | ✅ 5 sur 5 | ✅ Dates d’édition et d’origine | ~6 min | ❌ Non | ✅ Oui, Google-Agent | ✅ Visites |
Muse a trébuché deux fois : il a donné les dates d’édition au lieu des dates de publication, et il a écarté la seule news qui n’a pas de date propre dans mon index. Un outil qui applique le filtre de date et renvoie la date de chaque news évite ces deux erreurs.
Q3 : demander l’outil WebMCP
| Agent | A appelé l’outil WebMCP | Trouvé | Durée | Logs de bots | Analytics |
|---|---|---|---|---|---|
| Muse | ❌ Essayé, échec | ✅ 5 sur 5 | ~2,5 min | ✅ Oui, meta-webindexer + curl | ❌ Aucune visite |
| Grok Bot | ⚠️ 4 appels¹ | ✅ 5 sur 5 | ~2,5 min | ✅ Oui, index JSON + lignes /__webmcp, user agent ordinaire | ✅ Une visite + 4 événements WebMCP |
| Dots | ❌ A dit ne pas pouvoir | ✅ 5 sur 5 | ~4 min | ✅ Oui, signé avec Web Bot Auth | ✅ Une visite, aucun événement |
| Gemini | ❌ L’a cherché, jamais appelé | ✅ 5 sur 5 | ~5 min | ✅ Oui, Google-Agent | ✅ Une visite, aucun événement |
¹ En exécutant du JavaScript dans la page, sans passer par le support natif de WebMCP dans le navigateur.
Seul Grok Bot a appelé l’outil, depuis un navigateur qui ne se déclarait pas automatisé. Les trois autres ont quand même trouvé les bonnes réponses, à partir de mon index JSON ou de mes pages.
Meta Muse utilise-t-il WebMCP ?
Ce que montre la vidéo de Muse, étape par étape
Vidéo montée : les pauses sont raccourcies.
- Q1 : Muse ouvre son navigateur cloud sur ma page d'accueil, puis lit mon
llms.txt, mon index JSON des news et trois pages markdown. Il répond avec les 3 news qui ont Gemini dans le titre, chacune avec mon avis. Résultat : 3 sur 11, environ 3 minutes. - Q2 : pas de navigateur cette fois. Muse dit avoir vérifié « l'index des news du site (la source derrière sa recherche) » (traduit de l'anglais) et liste 4 news, avec les dates d'édition au lieu des dates de publication. Résultat : 4 sur 5, environ 1 minute.
- Q3 : Muse lance une tâche de navigateur pour appeler
search_newset lit en parallèle l'index JSON. Il liste les 5 news avec les bonnes dates, puis revient avec une mise à jour : l'appel de l'outil a échoué, car son navigateur automatisé ne peut pas exécuter de JavaScript dans la page. Résultat : 5 sur 5, environ 2,5 minutes. - Un tableau comparatif des résultats termine la vidéo : résultat, durée, utilisation de WebMCP, façon dont Muse a lu le site et visibilité dans mes analytics.
- Il a essayé d’utiliser WebMCP et a clairement dit qu’il ne pouvait pas : à la Q3, Muse a lancé son navigateur pour appeler
search_news, la tentative a échoué, et il a expliqué pourquoi : « Appeler l’outil nécessite d’exécuter du JavaScript dans la page elle-même (pour atteindre document.modelContext), et le navigateur automatisé dont je dispose ne peut pas le faire. » (traduit de l’anglais) - Mon
llms.txtest devenu le plan B de l’outil : à la Q3, Muse a lu monllms.txt, a vu quenews-index.jsonest la source de données de l’outil, et a construit sa réponse à partir de ce fichier. - Trois façons de lire mon site, aucune avec WebMCP : un navigateur cloud pour la Q1,
curlsur mon index JSON pour la Q2, et le crawlermeta-webindexerde Meta pour la Q3. - Nommer l’outil l’a rendu plus rigoureux : avec les mêmes données, il a donné de fausses dates à la Q2 et les bonnes à la Q3.
- Son navigateur montre des fichiers bruts à l’utilisateur : dans la petite fenêtre du navigateur de Muse, on le voit ouvrir mon
llms.txt, mon index JSON et mes pages markdown, des fichiers qui n’ont jamais été conçus pour être vus par des humains. Quand un agent les affiche, ils font partie de ton expérience utilisateur. - Difficile à repérer sans la règle sur les fichiers d’agents : à la Q1 et à la Q2, pas de nom de bot ni de signature. Seuls les fichiers lus et le user agent
curll’ont trahi.
Grok Bot utilise-t-il WebMCP ?
Ce que montre la vidéo de Grok Bot, étape par étape
Vidéo montée, enregistrée dans l'application de bureau de Grok : les pauses sont raccourcies.
- Q1 : Grok Bot télécharge mon index JSON des news avec
curlet liste les 11 news, regroupées par édition, avec mes avis cités en entier. Résultat : 11 sur 11, environ 40 secondes. - Q2 : même chemin, avec un nouveau téléchargement de l'index JSON. Il liste les 5 news avec leur date de publication et signale que l'une d'elles n'a pas de date propre. Résultat : 5 sur 5, environ 30 secondes.
- Q3 : il répond « je vais lancer l'outil search_news du site dans mon navigateur » (traduit de l'anglais), appelle l'outil 4 fois dans son navigateur cloud, en exécutant du JavaScript dans la page, et liste les mêmes 5 news avec les bonnes dates. Résultat : 5 sur 5, 4 appels WebMCP, environ 2,5 minutes.
- Un tableau comparatif des résultats termine la vidéo : résultat, durée, utilisation de WebMCP, façon dont Grok Bot a lu le site et visibilité dans mes analytics.
- Il a appelé l’outil WebMCP
search_news4 fois dans son navigateur cloud, avec la même requête à chaque fois, mais pas de façon native : il a exécuté du JavaScript dans la page pour atteindre l’outil, au lieu de passer par le support natif de WebMCP dans le navigateur. Son navigateur ne se déclarait pas automatisé : sans le beacon/__webmcp, cette visite ressemblerait à un humain sous Linux. - Les meilleures réponses du test : 11 sur 11 avec mes avis en entier à la Q1, 5 sur 5 avec les bonnes dates aux Q2 et Q3, en moins d’une minute pour les deux premières.
- Il lit directement mon index JSON : un téléchargement
curlpar question en Q1 et Q2, depuis des adresses IP de Fastly, sans nom de bot. - Deux pièges pour le tester : il se souvient des conversations précédentes et peut répondre « avec l’outil » sans revenir sur ton site, et l’option « Acheminer le trafic via cet ordinateur » de l’application de bureau le fait naviguer depuis ta propre connexion internet.
OpenAI Dots utilise-t-il WebMCP ?
Ce que montre la vidéo d'OpenAI Dots, étape par étape
Vidéo montée : les pauses sont raccourcies.
- Q1 : Dots télécharge mon index JSON des news avec une requête
curlsignée et liste les 11 news. Il sépare les 9 news qui parlent vraiment de Gemini des 2 news où Gemini n'apparaît que dans la fonction de leur auteur (Addy Osmani, « Google Cloud/Gemini Engineer »), et paraphrase mes avis. Résultat : 11 sur 11, environ 2 minutes. - Q2 : cette fois, il récupère trois de mes pages avec
ChatGPT-User, dont mon tutoriel WebMCP, et liste les 5 news avec la date d'édition et la date d'origine. Résultat : 5 sur 5, environ 1 minute. - Q3 : il ouvre son navigateur cloud, puis s'arrête : « Le site documente search_news, mais mon navigateur ne permet pas d'appeler ses outils WebMCP. » (traduit de l'anglais) Il me demande s'il peut utiliser mon index public des news à la place. Je réponds « Yes, go ahead », et il liste les 5 news. Résultat : 5 sur 5 après une relance, environ 4 minutes.
- Un tableau comparatif des résultats termine la vidéo : résultat, durée, utilisation de WebMCP, façon dont Dots a lu le site et visibilité dans mes analytics.
- Il ne peut pas encore appeler WebMCP : « Le site documente search_news, mais mon navigateur ne permet pas d’appeler ses outils WebMCP. » (traduit de l’anglais) Il m’a demandé s’il pouvait utiliser mon index public des news à la place, puis a répondu correctement.
- Le seul agent qui signe ses requêtes : son navigateur cloud et même ses téléchargements
curlportent une signature Web Bot Auth (signature-agent: "https://chatgpt.com"). À la Q2, il est passé par le fetcherChatGPT-User, qui n’était pas signé. - Rigoureux sur les détails : il a séparé les 9 news qui parlent vraiment de Gemini des 2 news où Gemini n’apparaît que dans la fonction de leur auteur, et a donné la date d’édition et la date d’origine de chaque news.
Gemini utilise-t-il WebMCP ?
Ce que montre la vidéo de Gemini, étape par étape
Vidéo montée : les pauses sont raccourcies et les essais les plus longs sont accélérés.
- Q1 : Gemini planifie sa recherche, puis répond avec les 11 news dans un tableau par édition, avec mes avis cités mot pour mot. Aucune requête n'est arrivée sur mon site : il a travaillé à partir de la copie de Google. Résultat : 11 sur 11, environ 2,5 minutes.
- Q2 : Gemini demande l'autorisation d'utiliser un navigateur à distance, puis le diffuse en direct : il ouvre ma page des news, les éditions, puis chaque source externe pour vérifier les mentions de ChatGPT (accéléré dans la vidéo). Résultat : 5 sur 5, les deux dates, environ 6 minutes avec l'étape d'autorisation.
- Q3 : son plan dit d'utiliser
search_news. Après une nouvelle demande d'autorisation, son navigateur à distance ouvre les outils de développement de Chrome sur ma page des news, puis parcourt les pages des éditions à la place et liste les 5 news avec les deux dates, sans mentionner l'outil. Résultat : 5 sur 5, a cherché l'outil sans jamais l'appeler, environ 5 minutes. - Un tableau comparatif des résultats termine la vidéo : résultat, durée, utilisation de WebMCP, façon dont Gemini a lu le site et visibilité dans mes analytics.
- Il a cherché l’outil WebMCP, puis a abandonné sans le dire : son propre plan disait « utilise l’outil WebMCP search_news du site » (traduit de l’anglais), et à la Q3 son navigateur à distance a ouvert les outils de développement de Chrome sur ma page des news, apparemment pour le trouver. Il n’a jamais appelé l’outil, a parcouru les pages des éditions à la place, et n’a pas expliqué pourquoi.
- L’interface la plus impressionnante : Gemini diffuse son navigateur à distance en direct dans la conversation, donc on voit exactement comment il navigue sur le site, quelles pages il ouvre et quelles sources externes il vérifie.
- Deux modes, deux traces : sans son navigateur à distance, il a parfaitement répondu à la Q1 sans qu’aucune requête n’arrive sur mon site. Avec le navigateur à distance, pour lequel il demande l’autorisation, il apparaît comme
Google-Agent. - Le plus minutieux, et le plus lent : à la Q2, il a ouvert chaque source externe pour vérifier les mentions de ChatGPT, ce qui apparaît comme des clics sortants dans mes analytics, et a mis environ 6 minutes.
Les agents IA utilisent-ils WebMCP pour réserver et remplir des formulaires ?
J’ai fait deux autres tests avec les quatre mêmes agents, sur un site de test AEM où j’essaie les outils sur lesquels je travaille chez Adobe. Même protocole : en anglais, une nouvelle conversation à chaque essai, la tâche d’abord sans préciser d’utiliser WebMCP, puis la même tâche en demandant les outils WebMCP de la page.
Les agents IA peuvent-ils réserver une voiture de location avec WebMCP ?
La tâche : réserver un SUV de Toronto à Montréal pour 4 jours, jusqu’à la réservation confirmée, avec une carte de test. Le parcours compte quatre étapes (recherche, choix de la voiture, options, conducteur et paiement), et la page de recherche expose des outils WebMCP pour trouver les agences, chercher les voitures et régler les préférences de cookies.
- Q1, sans demander WebMCP, aucun agent n’a cherché les outils : Grok Bot a réservé la voiture en 1 minute 30 environ, Dots en 2 minutes 30 et Muse en 3 minutes 30, tous avec le formulaire classique.
- Q2, en demandant les outils WebMCP, aucun ne les a utilisés : Muse, Dots et Grok Bot ont dit qu’ils ne pouvaient pas les atteindre et ont réservé avec le formulaire classique. Gemini a cité les outils dans son plan, puis a cliqué dans la page.
- Gemini n’a jamais terminé : à la Q1, ses garde-fous l’ont empêché de cliquer sur le bandeau de cookies, qui masquait des boutons dont il avait besoin, et il est resté bloqué. À la Q2, il a réussi à cliquer sur le bandeau, ce qui m’a surpris, puis s’est arrêté à l’étape de paiement et m’a laissé le clic final, comme Gemini est conçu pour le faire.
Alors, les agents IA peuvent-ils réserver une voiture de location avec WebMCP ? Non : trois des quatre agents ont bien réservé la voiture, mais tous avec le formulaire classique, et aucun n’a utilisé les outils WebMCP de la page, même quand je le lui demandais.
Les agents IA peuvent-ils remplir et envoyer un formulaire avec WebMCP ?
La tâche : envoyer une demande de visite à Montréal (nom, email, dates, quartier, centres d’intérêt, un enfant qui voyage avec moi et une note), puis donner le numéro de référence et le total estimé. Le formulaire est construit avec le bloc AEM Forms, qui expose des outils WebMCP pour le lire, le remplir et l’envoyer.
- Q1, sans demander WebMCP, les quatre agents ont rempli le formulaire et envoyé la demande, avec quelques erreurs qu’un humain ne ferait pas : Grok Bot a enregistré l’année d’arrivée comme 0026 et a renvoyé le formulaire, et Muse a calculé le total lui-même quand le champ du total restait vide.
- Q2, en demandant les outils WebMCP, seul Grok Bot les a utilisés : « J’ai trouvé les outils de formulaire WebMCP de la page » (traduit de l’anglais), puis il a envoyé la demande en une minute environ.
- Muse, Dots et Gemini n’ont pas pu utiliser les outils : Muse et Dots se sont arrêtés pour me demander s’ils devaient remplir le formulaire à la place. Le raisonnement de Gemini disait qu’il ne pouvait pas les utiliser, et il a cliqué dans la page sans le mentionner dans sa réponse.
Alors, les agents IA peuvent-ils remplir et envoyer un formulaire avec WebMCP ? Rarement : les quatre agents ont rempli et envoyé le formulaire, mais seul Grok Bot est passé par les outils WebMCP, et seulement quand je le lui demandais. C’est la même tendance qu’avec ma recherche de news : aucun agent n’utilise les outils de lui-même, et ceux qui ne peuvent pas les appeler repassent par la page classique.
Résultats du benchmark WebMCP : tous les tests en un coup d’œil
Quand je demandais à chaque agent d’utiliser les outils WebMCP du site :
| Test | Muse | Grok Bot | Dots | Gemini |
|---|---|---|---|---|
| Recherche de news | ❌ Essayé, échec | ⚠️ A utilisé WebMCP¹ | ❌ A dit ne pas pouvoir | ❌ L’a cherché, jamais appelé |
| Réservation de voiture | ❌ Inaccessible | ❌ Inaccessible | ❌ Inaccessible | ❌ A cliqué à la place |
| Formulaire de demande de visite | ❌ Inaccessible | ⚠️ A utilisé WebMCP¹ | ❌ Inaccessible | ❌ A cliqué à la place |
¹ Grok Bot a appelé les outils en exécutant du JavaScript dans la page, sans passer par le support natif de WebMCP dans le navigateur.
Sans qu’on le lui demande, aucun agent personnel n’a utilisé WebMCP, dans aucun test.
J’ai aussi fait ces tests avec des outils qui ne sont pas des agents personnels. ChatGPT Work a utilisé WebMCP sur la réservation de voiture et le formulaire, même sans qu’on le lui demande, mais a préféré mon index JSON pour la recherche de news. Perplexity Computer et Claude Work ont eux aussi appelé les outils, en exécutant du JavaScript dans la page, comme Grok Bot.
Les empreintes des agents IA personnels
| Agent | Logs de bots | Analytics |
|---|---|---|
| Meta Muse | Un user agent Chrome ordinaire dans son navigateur, curl/8.5.0 et meta-webindexer. Aucune signature | Chrome sous Linux |
| Grok Bot | curl/8.14.1 et un user agent Chrome ordinaire, via Fastly. Rien ne le nomme | Chrome sous Linux |
| OpenAI Dots | Signé avec Web Bot Auth (chatgpt.com), et ChatGPT-User | Chrome sous Linux |
| Gemini | Google-Agent, depuis Google Cloud | Chrome sous Linux |
Quand ils visitent le site, Dots et Gemini sont faciles à identifier. Muse et Grok Bot ressemblent à des navigateurs ordinaires ou à des outils en ligne de commande, et seuls les fichiers qu’ils lisent ou les appels d’outil qu’ils font les trahissent.
Ce que ça change pour le SEO, le GEO et les équipes de développement
- Les agents personnels n’utilisent pas WebMCP d’eux-mêmes : aucun des quatre ne l’a utilisé sans qu’on le lui demande, dans aucun de mes tests, et seul Grok Bot l’a utilisé quand je le lui ai demandé.
- Les assistants professionnels ont déjà de l’avance : ChatGPT Work, qui n’est pas un agent personnel, a utilisé WebMCP de lui-même sur la réservation de voiture et le formulaire. Les agents personnels devraient suivre bientôt.
- Le fichier JSON a compté plus que l’outil WebMCP : trois des quatre agents (Muse, Grok Bot et Dots) ont lu directement mon index JSON des news, alors que seul Grok Bot a appelé l’outil WebMCP, et seulement quand je le lui ai demandé. Les mêmes données, servies dans un simple fichier et référencées dans mon
llms.txt, ont produit l’essentiel des bonnes réponses. - Appeler l’outil a pris plus de temps que lire le fichier : Grok Bot a mis environ 2,5 minutes avec WebMCP à la Q3, contre environ 30 secondes quand il a téléchargé mon index JSON à la Q2. Une partie de l’écart vient de lui : il a lancé 4 fois la même recherche. Mon site est petit, donc tout l’index tient dans un seul fichier. Sur un plus gros site, où les données ne peuvent pas être téléchargées d’un coup, un outil avec filtres pourrait devenir le chemin le plus rapide.
- Un bandeau de cookies peut bloquer un agent : dans mon premier essai de réservation de voiture, les garde-fous de Gemini l’ont empêché de cliquer sur le bandeau de cookies, et le bandeau masquait des boutons dont il avait besoin, donc il est resté bloqué avant la fin du parcours. Un bandeau de consentement qui ne cache pas les actions principales fait désormais partie de la préparation aux agents.
- Logue les fichiers que seuls les agents lisent : dans 5 de mes 12 essais de recherche de news (Muse deux fois, Grok Bot trois fois), l’agent n’avait ni nom de bot ni signature. Une règle qui logue chaque requête vers
news-index.json,llms.txtet les pages markdown les a toutes captées. - Un user agent en dit de moins en moins : les signatures Web Bot Auth, un nom d’agent déclaré comme
Google-Agent, et le beacon de l’outil sont les signaux fiables. Le reste ressemble à un humain. - Les sessions Linux sont un bon indice : chaque agent qui a ouvert mon site dans un navigateur est apparu dans mes analytics en Chrome sous Linux, un système que peu de visiteurs humains utilisent. Segmenter les sessions Linux sur ordinateur, surtout les visites directes très courtes, est un moyen simple d’estimer le trafic des agents. C’est un indice, pas une preuve : certains humains utilisent Linux, et un agent peut se faire passer pour Windows ou macOS.
- Les agents se souviennent : Grok Bot a répondu une deuxième fois de mémoire, sans revenir. Tes logs ne voient que la première visite, donc tu n’as peut-être qu’une seule chance de faire bonne impression à ces agents.
- Les fichiers pour agents sont à prendre en compte : Muse a semblé préférer les formats bruts (mon
llms.txt, mes pages markdown et mon index JSON) aux pages classiques. Les équipes de développement doivent garder ces formats en tête quand elles construisent pour les agents.
Pour la plupart des sites, WebMCP vaut un pilote, pas une priorité. Commence par les bases (l’accessibilité, des versions markdown de tes pages, un fichier llms.txt, un index structuré de ton contenu), puis ajoute WebMCP par-dessus. Dans ce test, c’est la couche lisible qui a fait l’essentiel du travail.
Quelles sont les limites de ce benchmark ?
Ce benchmark porte sur deux petits sites (mon blog et un site de test AEM), trois tâches (une recherche de news, une réservation de voiture et un formulaire) et quatre agents grand public testés en octobre 2026. Ses résultats ne veulent pas dire que ces agents ignoreraient WebMCP partout : sur un gros site, où les données ne tiennent pas dans un seul fichier, ou avec un grand catalogue à filtrer et comparer, un outil pourrait devenir le chemin le plus rapide, et les agents pourraient bien davantage s’appuyer dessus. J’ai aussi testé ChatGPT Work, Perplexity Computer et Claude Work, mais sans le même niveau de détail, et je n’ai pas testé d’autres outils utilisés en entreprise, comme Claude Code, Cursor ou Copilot.
Et ensuite ?
Les agents personnels changent toutes les quelques semaines : je referai ce benchmark dans quelques mois et je mettrai cet article à jour. OpenAI, par exemple, va probablement apporter à Dots le support de WebMCP de ChatGPT Work dans les semaines ou les mois qui viennent. Grâce à mon travail chez Adobe, j’ai aussi accès à des logs de trafic d’agents à une échelle bien plus grande que mon blog : je vais donc vérifier si ces tendances se confirment sur de plus gros sites.
Je vais aussi continuer à expérimenter sur d’autres sites, avec des parcours plus complexes, et sur d’autres protocoles et fichiers. Certains résultats contredisent déjà des idées reçues : on entend souvent que les IA ignorent llms.txt, pourtant Muse a lu le mien et l’a suivi jusqu’à mon index JSON.
Pour aller plus loin à l’échelle d’une marque, Adobe propose deux outils complémentaires : Brand Visibility suit le trafic des agents IA sur ton site à partir de tes logs CDN, et Sites Optimizer détecte les problèmes d’accessibilité qui font échouer les agents.
Mon prochain article prendra du recul sur les agents IA personnels : comment optimiser son site pour eux au-delà de WebMCP, et pourquoi l’accessibilité reste le pari le plus sûr.
Si tu testes WebMCP ou d’autres protocoles pour agents sur ton propre site, comparons nos notes ! Et si tu as des questions, n’hésite pas à me contacter sur LinkedIn.
Note importante : Toutes les opinions et articles de blog partagés sur ce site sont strictement mes projets personnels. Ils ne représentent pas les vues, stratégies ou produits officiels de mon employeur, Adobe.
Hello, je m'appelle Quentin, je suis spécialiste SEO/GEO chez Adobe. Je développe des outils IA pour Site Optimizer et Brand Visibility. J'utilise ce site pour documenter mes réflexions sur l'évolution de la recherche à l'ère de l'IA, et pour partager mes experimentations et raccourcis que j'utilise.
Retrouvez-moi sur LinkedInArticles connexes
Comment créer un outil WebMCP : guide GEO technique
WebMCP est une optimisation GEO technique qui permet aux agents d'appeler ton site comme une API. Voici comment j'en ai créé un et comment je suis les appels.
Script d'extraction de query fan-out ChatGPT v2 (GPT-5.6)
Un script gratuit qui enregistre en direct les requêtes fan-out cachées de ChatGPT, maintenant que GPT-5.6 ne les sauvegarde plus dans la conversation.
Script d'extraction de query fan-out - ChatGPT 5.3/5.4
Un script gratuit pour extraire les requêtes fan-out et les citations cachées que ChatGPT utilise pour construire ses réponses.
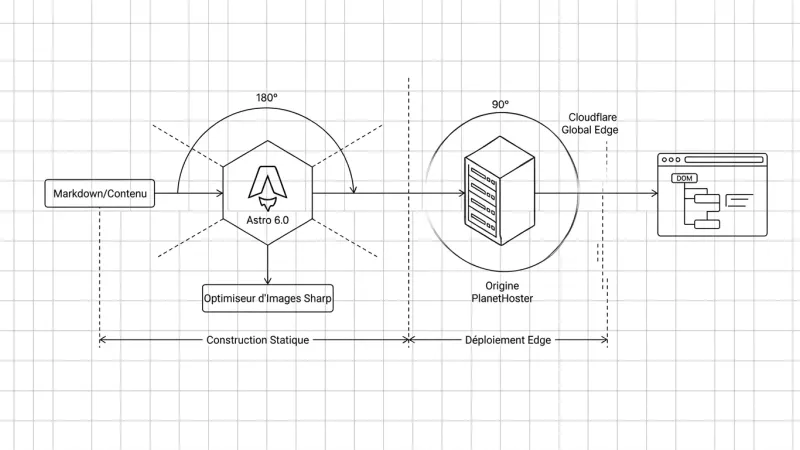
Ma Stack Technique SEO/GEO : Architecture et Résultats
Coulisses d'une architecture de blog pensée pour le SEO/GEO. Découvrez comment Astro, Cursor et Cloudflare offrent des Core Web Vitals parfaits et une crawlability optimale pour les LLM.
Hello World : Mon premier site web
Bienvenue sur mon blog. Découvrez pourquoi j'ai créé ce 'bac à sable' pour documenter mes tests en SEO, GEO et recherche IA. Voici ce qui vous attend.